
Привет! С июня по сентябрь мы учили работать с AI более 40 специалистов из продуктовых команд крупной международной IT-компании. По условиям NDA и по просьбе партнёра мы не называем компанию и участников, но нам важно рассказать о проекте, поделиться результатами и главными выводами.
Старт работы
AI как технология всё чаще применяется в продуктовых командах для решения разнообразных задач, начиная с аналитики и заканчивая процессами Product Discovery и Product Delivery. Постепенно AI становится базой и одной из ключевых компетенций в продакт-менеджменте и других смежных областях, однако в большинстве команд работа с ним пока носит хаотичный и несистемный характер.
С одной стороны, технология только развивается, поэтому это нормальное состояние почти для всех компаний. С другой стороны, её внедрение уже сейчас может значительно ускорить процессы и повлиять на эффективность команд и, как следствие, на бизнес-результаты.
Именно с запросом выстроить системную работу с AI к нам пришли CPO и L&D-команда компании. Главную задачу обучения мы сформулировали так: помочь сотрудникам получить крепкий фундамент в работе с AI в продукте, чтобы затем они применяли его в повседневных задачах.
Наш пайплайн работы мы разбили на следующие этапы:
- Подготовка программы.
- Проведение обучения.
- Оценка результатов.
Дальше мы расскажем про каждый из них подробнее.
Подготовка программы
Мы изначально договорились, что нужно кастомное обучение под задачи сотрудников, чтобы они могли сразу применять знания в работе.
Для этого мы проводили исследования:
- Серия встреч и интервью с CPO и L&D-командой, чтобы понять ожидания и лучшие практики обучения на основе предыдущего опыта компании.
- Вместе с L&D-командой собрали запросы и опасения хедов продукта и поговорили с лидами исследований, аналитики и Product Ops, чтобы понять, на чём сфокусироваться и каких сценариев лучше избегать.
- Кабинетное исследование и разбор внутренних опросов о том, как сотрудники сейчас работают с AI.
- Наш собственный опрос при записи на обучение: участники оценивали, насколько системно используют AI в своих процессах.
- Разбор стека компании: какие инструменты используются, что уже подключено к корпоративному AI, где хранится документация и другие вопросы.
Также нужно было учесть несколько важных условий:
- Учиться будут продакт- и проджект-менеджеры, но с очень разным уровнем использования AI на старте.
- Подавляющее большинство из них уже использовало AI-инструменты, а значит, начинать обучение с нуля и учить азам точно не стоило.
- У сотрудников была всего пара часов в неделю на обучение, так что требовалась насыщенная, но достаточно компактная программа.
- Команды работают из разных часовых поясов, а обучение компания проводит в рабочее время, поэтому воркшопы поставили на дневные часы.
В итоге мы решили разделить программу на две последовательные ступени, общую цель которых описали так: перевести работу с AI с уровня «умею, но делаю бессистемно» на уровень «регулярно оптимизирую свою работу через AI». Мы хотели, чтобы у всей команды в компании появился общий язык, а участники ушли с автоматизациями, которые работают в их реальных проектах.
Первая ступень с июня по июль — база и общий язык. Формат подразумевал, что мы проведём шесть двухчасовых воркшопов по ключевым темам цикла работы над продуктом с учётом AI-технологий и процессов внутри компании:
- Agentic Foundation
- Research Agents
- Product Ops Agents
- Dev Agents
- Evals, Orchestrations, Pipelines
- Final Q&A
Наши исследования заметно повлияли на программу. Например, изначально в ней был отдельный воркшоп по аналитике, но после разговора с профильной командой мы от него отказались: работа с данными требует глубокого понимания того, как они устроены, а у аналитиков уже есть свои планы по AI-инструментам. Тему в итоге мы коротко разобрали в воркшопе про Product Ops.
Вместо него появился отдельный модуль про evals и контроль качества. Хеды опасались, что AI начнёт производить много убедительного, но непроверенного результата, который потом придётся разбирать смежным командам. Поэтому мы учили не только получать ответы от AI, но и проверять их, а ещё разбирали, какие решения должны оставаться за сотрудником.
Ещё один запрос хедов — научить продактов видеть, какие процессы вообще стоит автоматизировать. Это стало сквозной линией программы: с упражнения на скоринг собственной рутины начинался первый воркшоп, и оно же помогало выбирать проекты для второй ступени.
С лидом исследований договорились, что именно стоит тренировать: desk research с помощью AI-поиска и умение давать модели контекст. А синтез интервью, работу с синтетическими респондентами и выбор методологии оставили сотрудникам.
Подробнее о каждом воркшопе мы расскажем в следующем разделе.
К слову, об инструментах: доступ к AI у сотрудников уже был, поэтому мы строили обучение на том, чем они и так пользуются. Базовым стеком стали Claude и Claude Code, VS Code и GitHub — простая связка, которая позволила ребятам работать с AI на интенсиве без лишних усложнений. По ходу добавились также Vercel, MCP-коннекторы к рабочим сервисам и promptfoo.
Вторая ступень с августа по сентябрь — проектная работа. Здесь у нас получилось четыре недели плотной практики: сотрудники в кросс-функциональных командах до четырёх человек работали над собственными проектами. Цель — пройти путь от описания требований к агенту до работающего MVP с набором тест-кейсов.
В качестве главного ведущего и спикера мы совместно выбрали Искандера Хабибрахманова — продакт-менеджера и AI-предпринимателя, основателя Hyperverse, Skill Labs, Kardamon.ai и Shanc.ai, ex-CPO в Emex и Legionfarm (YC W20). Какие факторы повлияли на выбор:
- У Искандера 15-летний опыт не только продакт-менеджера, но и разработчика, поэтому на протяжении всего интенсива он мог доступно объяснять технические нюансы.
- Работал с AI ещё до нынешнего бума и запускал собственные AI-решения и продукты, поддерживая и развивая их самостоятельно.
- Он глубоко разбирается и в software, и в hardware: например, разработал AI-систему трекинга тела на базе компьютерного зрения и камеру усталости в Яндекс Такси.
- Профильное образование в IT и бизнес-информатике (НИУ ВШЭ), побеждал в олимпиадах по математике.
Также немаловажным фактором было то, что помимо глубокого знания темы у него есть опыт преподавания: его интенсивы на платформе Roots прошли 150+ человек и поставили им высочайшие оценки. Для контекста: за всё время не было ни одной жалобы на работу Искандера или просьбы о возврате.
Роли мы распределили с самого начала: всю организационную и методическую часть — программу, воркшопы, онбординг, инструкции, чаты — готовили сами и отдавали команде компании на ревью. L&D-команда помогала с контекстом, анонсами и набором участников.
На подготовку и запуск программы с момента знакомства и первой встречи мы потратили три недели. Сюда входила не только разработка содержания, но и:
- Собственная платформа для обучения: онбординг, программа, записи эфиров, конспекты и сбор фидбека.
- Бот поддержки, который помогал с техническими вопросами: установкой инструментов, ошибками, доступами. Так общий чат оставался для обсуждения сути, а не просьб «помогите, у меня сломалось».
- Настройка сервисов: Telegram-сообщество, Zoom и Google Calendar.
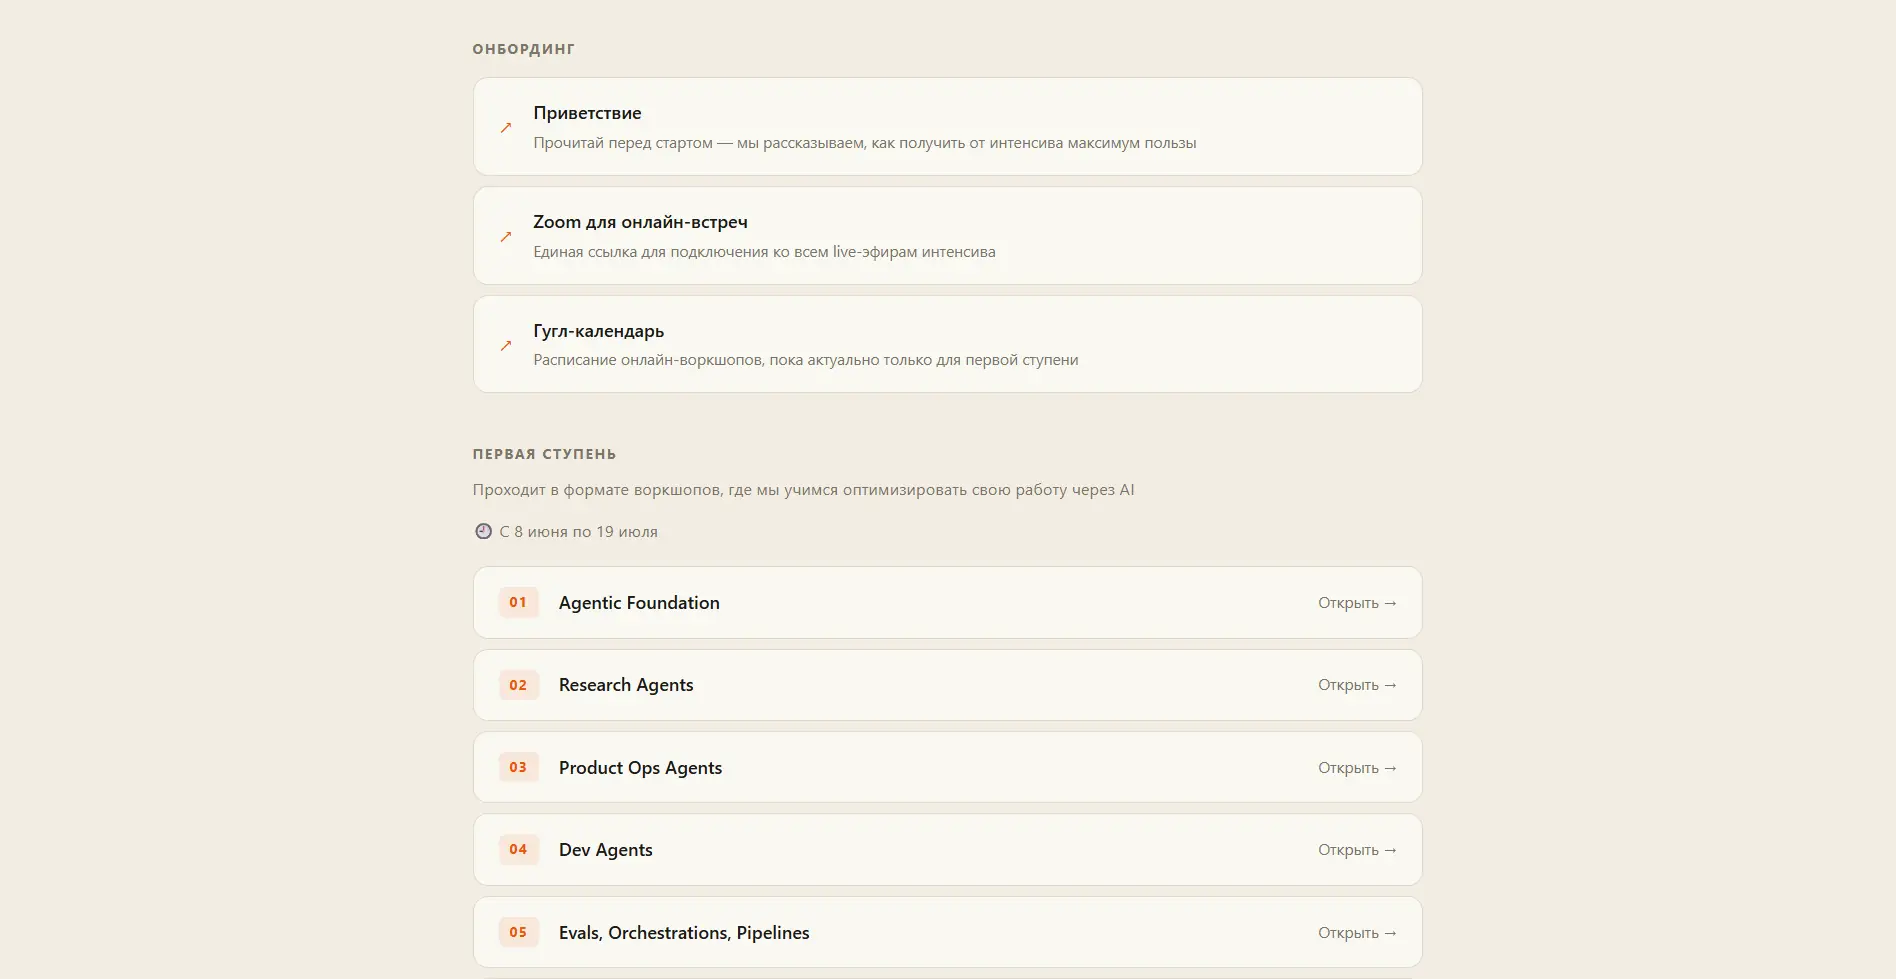
Важно отметить, что во время обучения мы ещё и на собственных примерах показывали, как работают AI-инструменты, чтобы вдохновить ребят. Например, платформу и агентов — вроде того, который присылал напоминания об эфирах, — мы полностью сделали с помощью AI. С такой программой и сетапом мы и стартовали.
Как прошла первая ступень
На первую ступень записались больше 40 человек, в том числе хеды продукта со своими, более управленческими задачами — их кейсы мы тоже учитывали.
Глобальная идея первой ступени была в том, чтобы повысить эффективность продуктовых команд за счёт перехода от AI как полезного помощника и умного чат-бота к построению процессов вокруг AI. Этот подход основан на трёх опорах:
- Контекст — как передать агенту личный контекст и знания о компании.
- Инструменты — как дать агенту возможность действовать.
- Доверие — как сделать так, чтобы агенту можно было доверять.
В каждом модуле мы разбирали лучшие практики в конкретной области, расширяли набор инструментов участников и сразу применяли их. Воркшопы проходили раз в неделю и длились по два часа: после теории ребята переходили к упражнениям на кейсах компании — часто в мини-группах, где вместе искали решение. После каждого эфира участники получали запись и конспект с ключевыми идеями и расшифровкой терминов.
Коротко расскажем о структуре и логике обучения.
Первый воркшоп Agentic Foundation был посвящён вопросу, что такое агент и какой процесс ему отдавать. Мы определяли агента как систему, которая использует LLM, чтобы управлять ходом работы: вывод модели сам решает, что сделать, какой инструмент вызвать и когда остановиться.
Из этого определения мы вывели анатомию агента:
- LLM — большая языковая модель.
- Контекст — системный промпт и история.
- Инструменты — скиллы, Bash и MCP-коннекторы к рабочим сервисам.
- Агентский цикл с триггером запуска.
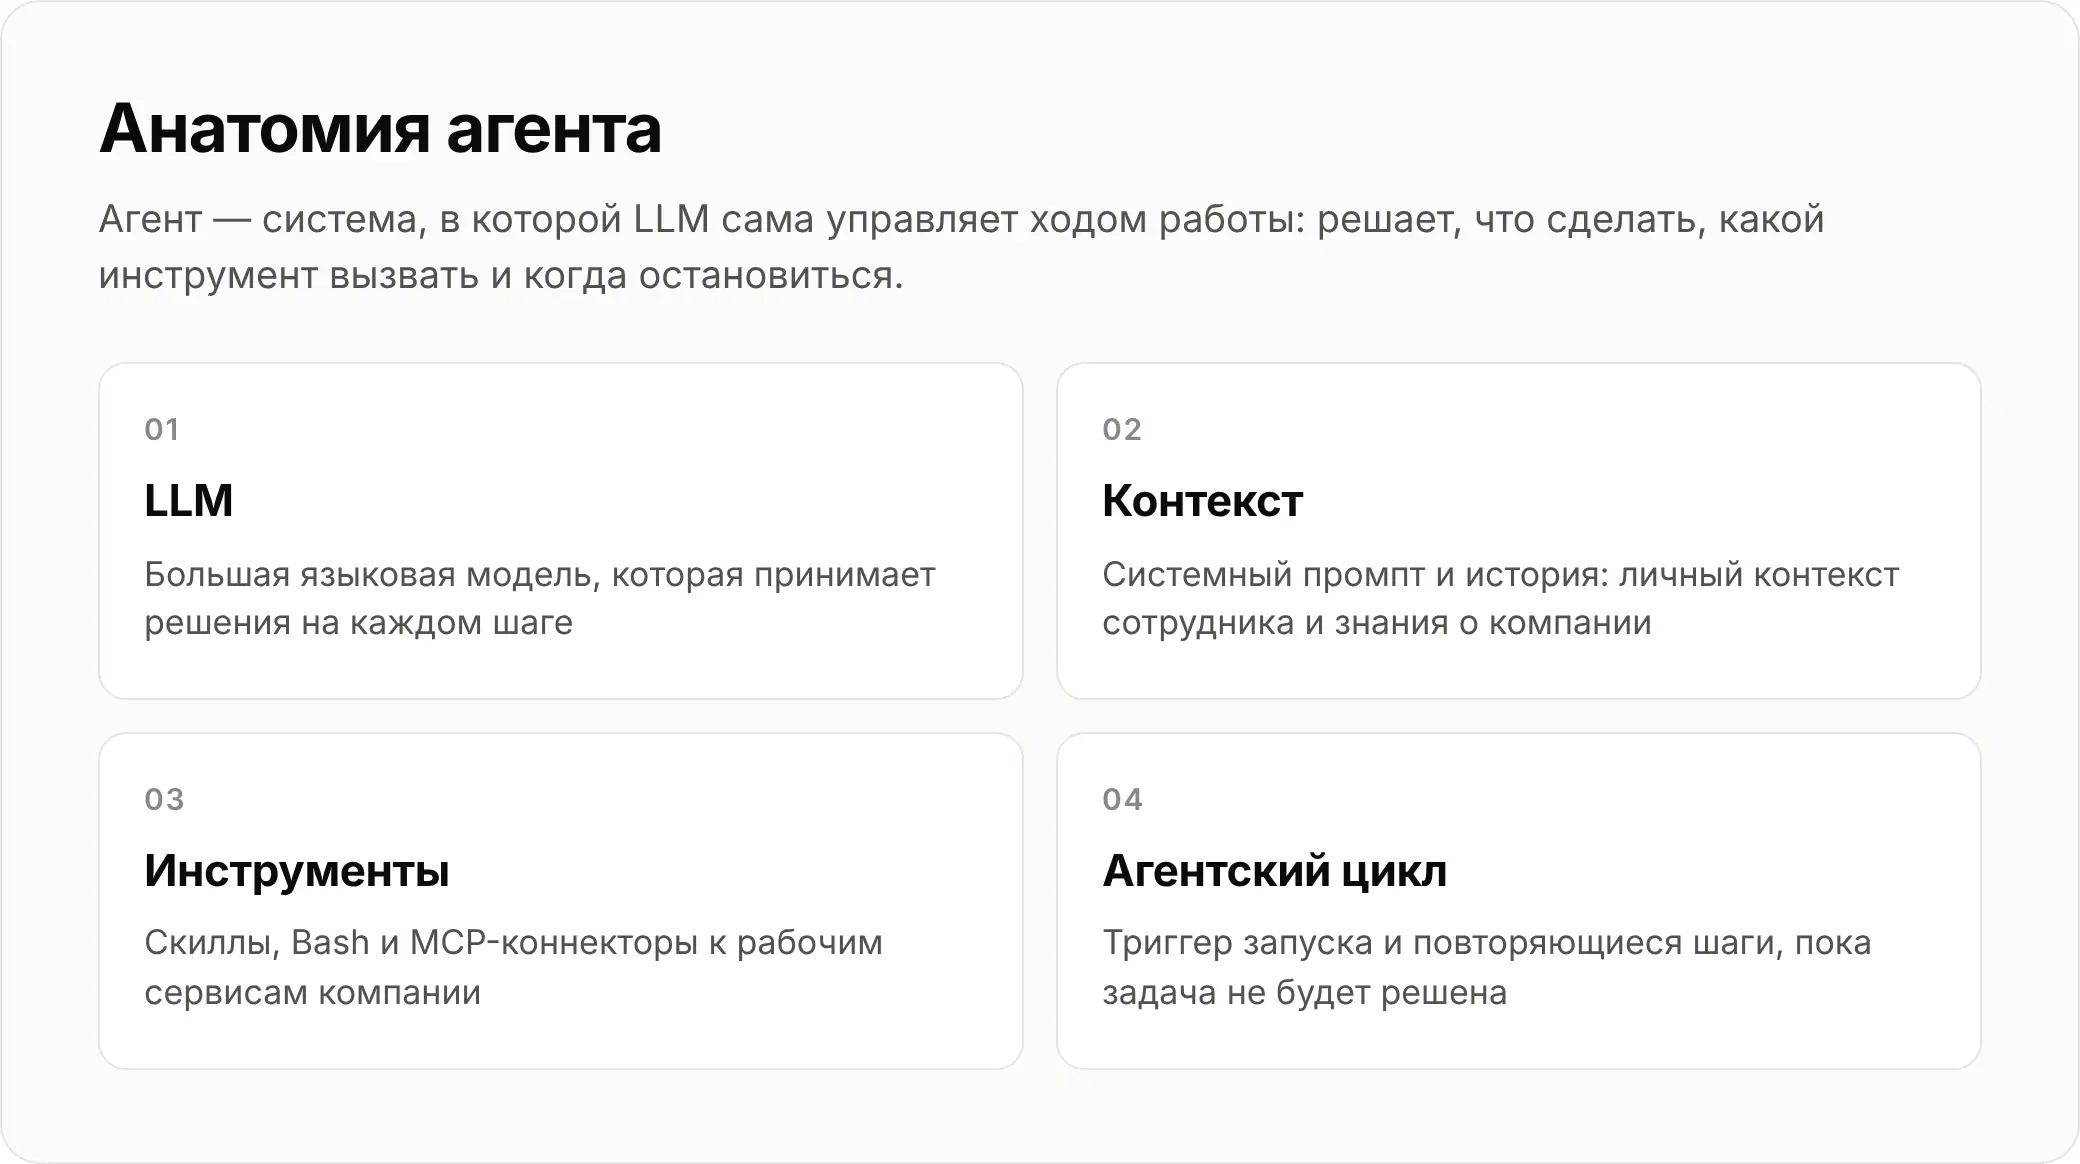
Именно эту анатомию мы дальше использовали, чтобы разбирать продуктовые процессы и делать проекты в рамках следующей ступени. Главным упражнением первого воркшопа был скоринг собственных задач: каждый участник оценивал их по четырём критериям — ценность, контекст, инструменты и проверяемость. Так ребята учились видеть, что стоит отдавать агенту, а что пока ещё рано.
Во втором воркшопе мы обсуждали Research Agents, которые собирают информацию извне, готовят её и сохраняют в структурированном виде. Их работу мы разложили на три стадии — Retrieve → Generate → Validate:
- Retrieve — сбор первичных данных из источников.
- Generate — обработка собранного и приведение к нужному формату.
- Validate — проверка результата.
Главное, что мы хотели донести на этом воркшопе, — подход к валидации. В обычном продукте логику проектируют так, чтобы ошибок не было, а с LLM так не получится, потому что модель недетерминирована. Поэтому цель другая: не чтобы агент не ошибался, а чтобы он видел и исправлял свои ошибки. Особенно это важно в задачах, где много интерпретации и широкий контекст, например в исследованиях рынка и конкурентов.
После внешних агентов в третьем воркшопе мы поговорили про внутренние — Product Ops Agents. Такие агенты отвечают и действуют на основе информации из базы знаний, рабочих чатов, таск-трекера, баз данных и других внутренних источников. Как и в предыдущем воркшопе, процесс мы разложили на три стадии:
- Retrieve — извлечение знаний, например через подготовку документов, индексацию, выбор способа поиска и восстановление контекста.
- Generate — ответ по найденным материалам в заданной чёткой структуре.
- Validate — проверка ответа, чтобы убедиться, что агент работает корректно.
В четвёртом воркшопе — Dev Agents — мы рассмотрели разработку как цепочку превращения требований в код и разобрали, где в ней место продакта: бизнес-требования, прототипы и приёмка.
На практике ребята собирали прототип от идеи до живой ссылки: создавали репозиторий в GitHub, делали дизайн в Claude Design, писали по нему код в Claude Code и публиковали через Vercel.
И наконец, пятый воркшоп — Evals, Orchestrations, Pipelines — тот самый модуль, который появился в программе после разговоров с хедами. Качество работы агентов нестабильно, так как LLM на один и тот же вопрос отвечает по-разному. Поэтому мы разбирали:
- Как проверять, что ответ соответствует требованиям.
- Как оценивать траекторию решения: нужные инструменты агента вызываются, а запрещённые — нет.
- Как организовать тестирование агентов.
Также обсудили ключевые метрики — task success, instruction following, tool choice, groundedness, efficiency и другие. Для автоматических прогонов показали promptfoo.
В заключение на шестом воркшопе мы провели Q&A-сессию, где подвели итоги первой ступени, разобрали вопросы и кейсы участников и свели весь материал в план автоматизации продуктового процесса агентом:
- Скоринг и выбор процессов.
- Подготовка контекста.
- Создание скиллов.
- Выбор и разработка инструментов.
- Дизайн агентского цикла: триггеры и валидация.
- Оценка качества и тест-кейсы.
- Хостинг.
- Тестирование и доработки.
По этой же логике мы выстроили и вторую ступень, где ребята создавали уже конкретные проекты. В итоге первая ступень дала участникам общее понимание того, как работают агенты в продуктовой разработке. А те, кто хотел разобраться глубже и сделать собственный AI-кейс, продолжили на второй.
Следует сказать, что программа первой ступени не была статичной и формальной благодаря кастомному подходу к обучению — мы регулярно собирали обратную связь и меняли формат прямо по ходу. Фидбек приходил через форму на платформе, короткий опрос в конце эфира и открытый тред в рабочем чате компании, который вела L&D-команда.
Участникам сразу зашли работа в мини-группах, практика с первого же занятия и конспекты, которые помогали коротко закрепить основные понятия. А вот что пришлось менять:
- Вовлечённость. На первом воркшопе ребятам было непривычно включать камеры и говорить вслух. Мы стали предлагать на коротких упражнениях отвечать голосом, а не печатать в чат, и уже на втором воркшопе участники заметно оживились: включали микрофоны и активнее задавали вопросы.
- Темп практики. Повторять за Искандером в реальном времени оказалось сложно: скорость у всех разная, в том числе из-за производительности компьютеров и качества интернета. Кто-то справлялся за 5 минут, а кто-то за 30. Мы увеличили время на практику до 45 минут, а для тех, кто справляется быстрее, подготовили задания со звёздочкой.
- Понятность заданий. Перед каждым блоком стали объяснять, зачем он нужен, а перед практикой — показывать готовый результат, к которому нужно прийти.
- Сложность теории. Снизили техническую глубину и добавили больше продуктовых примеров. Термины вынесли в конспекты, которые стали подробнее, и собрали отдельный документ со всеми практическими заданиями и их целями, чтобы участники могли наверстать пропущенное.
- Вопросы. Часть ребят стеснялась спрашивать в общем чате, поэтому мы предложили писать Искандеру в личку, а полезные для всех ответы потом дублировали в чат.
- Время. По опросу ближе к концу ступени примерно 50% участников ещё изучали материал. Поэтому тем, кто не пошёл на вторую ступень, мы продлили поддержку с шести до десяти недель, чтобы они могли задавать вопросы и доделывать упражнения.
Как прошла вторая ступень
Если первая ступень давала общую базу, то вторая была про практику: за четыре недели команды должны были пройти путь от идеи до работающего агента, который решает реальную задачу компании.
Формат второй ступени и принципы отбора мы обсуждали с L&D-командой ещё до старта обучения. Важно было избежать судьбы хакатонных проектов: такие решения часто быстро затухают. Поэтому мы договорились о трёх принципах:
- Проект решает реальную задачу бизнеса. Идея должна вписываться в продуктовый флоу, улучшать процесс хотя бы для одной команды и иметь потенциал для масштабирования.
- Идеи проходят калибровку. Их собирали в общей таблице: участники предлагали свои и отмечали, хотят ли делать их сами, а CPO и хеды продукта добавляли задачи, которые считали полезными. Затем итоговый список согласовали с ними же, а Искандер оценил каждую на реализуемость и сложность.
- Команды кросс-функциональные. К продакту подключались коллеги из других специализаций: например, если идея про аналитику, в команду звали аналитика. На одобренные проекты участники записывались сами, а мы вместе с L&D-командой помогали добрать состав.
В итоге в работу взяли 12 проектов. Они покрывали самые разные функции — поддержку, финансы, найм, маркетинг и саму разработку: от агента для мониторинга рынка до флоу разработки, в котором вместо классической команды работают продакт и AI-инструменты.
Команды мы разделили на две группы по типу агента: одни структурировали преимущественно внешние данные, другие работали с внутренними системами. Группы занимались в разные дни, а внутри каждой собрались похожие по реализации проекты: проблемы у них во многом пересекались, поэтому решались быстрее.
Каждый воркшоп был устроен как коворкинг и длился два часа: 30 минут разбора вопросов и 90 минут работы в командах в отдельных комнатах. Искандер переходил из комнаты в комнату и помогал там, где команда застряла. Между встречами вопросы можно было задавать в чате или на индивидуальном созвоне с ним, а мы в конце каждой недели собирали статусы по проектам, чтобы следить за прогрессом.
Перед каждым воркшопом мы публиковали короткую подсказку с выжимкой из первой ступени, чтобы ребята быстро вспомнили теорию и сразу переходили к делу. А тем, кто уверенно чувствовал себя в материале, предлагали не ждать встречи и двигаться с опережением графика.
Неделя за неделей команды проходили по одному этапу, и к концу каждого воркшопа у них должен был появиться конкретный результат. На первой неделе описывали требования к агенту и заполняли его карточку — описание скиллов, инструментов и агентского цикла, которое потом служило техзаданием для Claude. На второй собирали сами скиллы и подключали инструменты. На третьей занимались evals и проверкой качества, чтобы собрать минимальный набор рабочих тест-кейсов. На четвёртой настраивали агентский цикл и хостинг, чтобы получить MVP, у которого понятно, когда и как он запускается и где живёт.
Для этого мы предложили запускать агентов на базе Claude Code на выделенном сервере — так они могли работать без участия авторов, а команды сразу получили систему скиллов и другие возможности из коробки.
По отзывам участников, лучше всего сработало выделенное время в календаре: за пределами этих слотов часть ребят почти не занималась проектом, так что формат совместной работы прямо на воркшопе себя оправдал на 100%. Сама ступень воспринималась скорее как проектная работа, чем как учёба, — и это ровно то, чего мы хотели: применить знания первой ступени к реальной задаче и максимально погрузиться в устройство агентов.
Получается, что всего за четыре воркшопа по два часа каждая команда прошла путь от идеи до агента, развёрнутого на сервере. А завершилась ступень демо: все проекты команды представили внутреннему продуктовому сообществу на трёх встречах.
Оценка результатов
Их мы тоже разберём отдельно по каждой ступени.
Первая ступень. По её итогам мы вместе с L&D-командой провели анонимный опрос, и медианная оценка полезности обучения составила 8 из 10, что соответствует нашим внутренним бенчмаркам.
Оценки отдельных модулей разошлись: каждый из них одной части участников показался «очень полезным», а другой — «в целом нормальным», причём разным людям зашли разные темы. Для нас это подтверждение того, что на обучение пришли сотрудники с разным опытом работы с AI, и решение охватить в программе разные процессы себя оправдало. Самые высокие оценки получил модуль про evals — «очень полезным» его назвали почти 80% участников.
Чаще всего ребята отмечали понятное объяснение сложных тем, практику прямо на воркшопах, работу в командах, записи с конспектами и саму структуру программы, которая повторяла продуктовый процесс.
Самым частым возражением стала нехватка времени на обучение и практику, поэтому мы продлили поддержку участникам. Часть ребят ждала немного другого фокуса: не агентов, а, например, ежедневного использования LLM или их встраивания в продукты. Здесь мы согласились с наблюдением L&D-команды: люди часто неточно оценивают свои AI-навыки, и даже подробное исследование на входе не гарантирует ровного уровня группы. Поэтому программу было важно проектировать гибко и быть готовыми перестраивать её на ходу.
Вторая ступень. Главный для нас результат — из 12 проектов не отвалился ни один. Посещаемость была почти стопроцентной: на каждом воркшопе были представлены все команды. К концу ступени:
- 6 проектов (50%) дошли до готового MVP агента.
- 3 проекта (25%) остановились в одном шаге от MVP.
- 3 проекта (25%) — в двух шагах.
При этом выложить агентов на сервер получилось у всех команд, хотя на старте ребята не знали, как это делается. Это подтвердил и анонимный опрос в конце ступени: ни одна команда не выбрала вариант «прогресс небольшой — не знаем, как закончить». У ребят есть все навыки, чтобы самостоятельно довести проекты до конца и на их основе запускать следующие.
Свои проекты команды показали на демо для продактов и хедов. Формат выстроила L&D-команда по своему внутреннему флоу: на каждый проект отводилось 15 минут — короткая презентация, живое демо и вопросы из зала. В презентации команды рассказывали, какую проблему решали, как устроен инструмент и как его планируют развивать и поддерживать дальше.
Часть проектов уже заметно повлияла на метрики:
- Регулярный контроль качества. Команда собрала пайплайн из нескольких агентов для разметки данных: он проходит путь от файла до готового отчёта меньше чем за сутки, а вручную проверяется только 10–15% выборки, поэтому контроль качества теперь можно проводить регулярно. А в тестах с более лёгкой моделью для простых классификаций команда снизила затраты примерно на 60% и вдвое ускорила работу.
- Мониторинг рынка для продуктового маркетинга. Ручной сбор промоакций, рекламы и партнёрств конкурентов занимал около полудня раз в 2–4 недели. Тестовый прогон агента по данным за месяц занял 50 минут и собрал даже чуть больше, чем человек вручную, а формат отчёта уже одобрила команда продуктового маркетинга.
Другие проекты пока на стадии пилота, но уже показывают, куда можно двигаться дальше. Например, агент для аудита видимости в AI-поиске получает на вход домен сайта, который приводит компании пользователей, и показывает, цитируют ли его Google, ChatGPT и Perplexity, кого цитируют вместо него и что поменять на конкретных страницах. На тестовом прогоне агент показал, что проверяемый сайт виден в AI-ответах по 56% главных запросов, но лишь в 10% случаев, когда вопрос задают так, как его задал бы живой человек.
А агент для продуктовой документации сам собирает материалы по фиче и раскладывает их по единому шаблону PRD, ничего не выдумывая: если данных нет, он выносит вопросы автору, а если материалы противоречат друг другу, показывает, что с чем не сходится. Он также разбирает готовый документ и задаёт вопросы от лица разработчика, аналитика и дизайнера. Решения и публикация при этом всегда остаются за продактом.
Эффект остальных проектов будет расти по мере того, как команды встроят агентов в регулярную работу.
Помимо самих проектов, у компании остались наработки, которые продолжат работать и после обучения:
- Инфраструктура. Выделенный сервер, на котором уже живут агенты команд и можно запускать следующие.
- Формат работы. Коворкинг с экспертом, который мы использовали на второй ступени, компания планирует применять и дальше: он оказался очень эффективным.
- Материалы. Все записи эфиров, конспекты, презентации и дополнительные уроки остаются у команды с постоянным доступом, и к ним сотрудники смогут возвращаться в любой момент.
В конце нашей совместной работы мы провели финальную встречу с L&D-командой, где, во-первых, разобрали результаты каждой ступени, а во-вторых, признали обе ступени успешными.
Итоги
Для нас с Искандером этот проект стал примером того, как обучение даёт не только знания, но и бизнес-результат — тот самый, которого многие компании ждут от внедрения AI. На наш взгляд, сработало несколько вещей:
- Программа под задачи компании. Исследования с хедами и лидами направлений определили, на чём фокусироваться и чего избегать.
- Гибкость. Мы регулярно собирали обратную связь и перестраивали формат прямо по ходу обучения.
- Реальные задачи. Проекты отбирали по понятным критериям, поэтому они решают задачи бизнеса и не затухают после демо.
- Выделенное время и эксперт рядом. Воркшопы в формате коворкинга дали командам слоты в календаре и возможность сразу получить помощь эксперта — это вовлекло сотрудников компании и помогло дойти до конца.
Результат оценили и в самой компании — вот что написали нам коллеги из L&D-команды в одном из рабочих чатов:
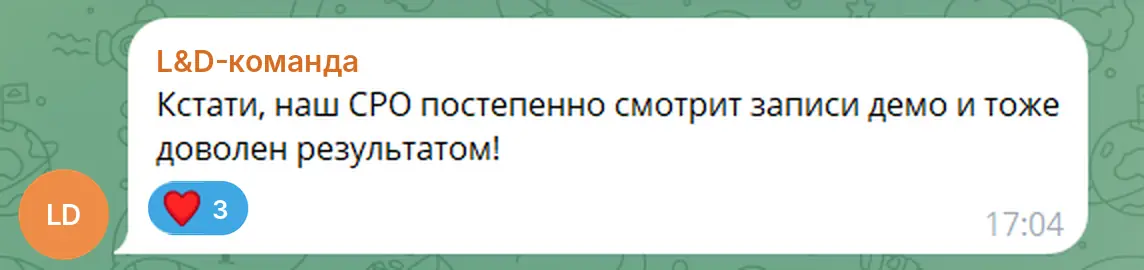
Для нас такие оценки важны не меньше, чем цифры выше, поэтому напоследок мы благодарим всю команду и сотрудников, поскольку без них такой интересный и сложный проект был бы просто невозможен!


